论文精读:语言模型是少样本学习者(Language Models are Few-Shot Learners)
从通用语言模型的动机、in-context learning、175B 参数规模、数据配比到测试集污染,整理一次 GPT-3 论文精读后的知识笔记。
读完 Transformer 以后,再读 GPT-3,感觉很顺。Transformer 解决的是模型结构和并行计算的问题;GPT-3 这篇真正让我在意的是另一个问题:如果我只是把一个自回归语言模型做得足够大,它会不会开始像一个通用任务接口?
论文是 Brown 等人的 Language Models are Few-Shot Learners。标题说得很大,但文章本身没有太多新结构。它更像一次历史级 scale experiment:沿着 GPT-2-style decoder-only language model 往上堆,把最大模型推到 175B,然后系统地问一句话:
模型不 fine-tune,只靠 prompt 里的说明和例子,能不能做很多 NLP 任务?
这篇文章我最后不是按 benchmark 记的。我更愿意把它记成一次范式切换:任务适配从参数更新,开始往上下文交互里移动。
它不是 scaling law 的创始
我一开始也会下意识把 GPT-3 和 scaling law 绑在一起。现在我觉得要分清楚。
系统讲 scaling law 的代表是 Kaplan 等人的 Scaling Laws for Neural Language Models。那篇是在讲参数量、数据量、compute 和 loss 之间的经验规律。GPT-3 论文引用了这个思路,但它不是 scaling law 的源头。
GPT-3 的位置更像是:它把 scaling hypothesis 做成了一次大实验。过去大家知道 scale 能降低 language modeling loss;GPT-3 进一步展示,scale 不只是让 perplexity 好看,还会让模型更会利用 prompt 里的例子。
所以我现在会这样记:
Scaling Laws:scale 和 loss 的规律。
GPT-3:scale 和 in-context task adaptation 的实证。
Chinchilla:scale 时参数和 token 数该怎么配。
GPT-3 的价值不在于“发现参数越大越好”这么粗的句子,而在于它让很多人第一次认真相信:一个足够大的 next-token model,可以用自然语言和少量样例临时指定任务。
这篇的 motivation:做一个更通用的模型
GPT-3 开头在批评当时的主流范式:
pretrain -> 为每个任务收数据 -> fine-tune -> test
这个范式比从零训练任务模型已经强很多,但它还有一个尾巴:每个新任务都要几千到几十万条标注数据,还要单独 fine-tune。模型结构是 task-agnostic 的,训练过程却不是。
作者给了三个理由。
第一,现实里很多任务没有大规模标注数据。让模型改语法、解释概念、仿写格式、评论短文,这些任务不可能每个都认真收几万条数据。
第二,大模型很会钻窄数据集的空子。论文里那句我觉得很值得记:
the potential to exploit spurious correlations in training data fundamentally grows with the expressiveness of the model and the narrowness of the training distribution.
说人话就是:模型越强,任务训练集越窄,它越容易学到伪相关。benchmark 分数可能很漂亮,换个分布就露馅。
第三,人不是这样学新语言任务的。人通常看一句说明,或者看两三个例子,就能大概知道任务要做什么。
所以 GPT-3 想做的事情是:
不要每个任务都更新参数。
训练一个通用 LM,然后在 prompt 里告诉它当前任务。
这也是为什么这篇文章一直强调 zero-shot、one-shot、few-shot。这里的 few-shot 不是 few-shot fine-tuning。它只是把几个 demonstrations 放进上下文,不做梯度更新。
Figure 1.1:prompt 像一个临时小训练集
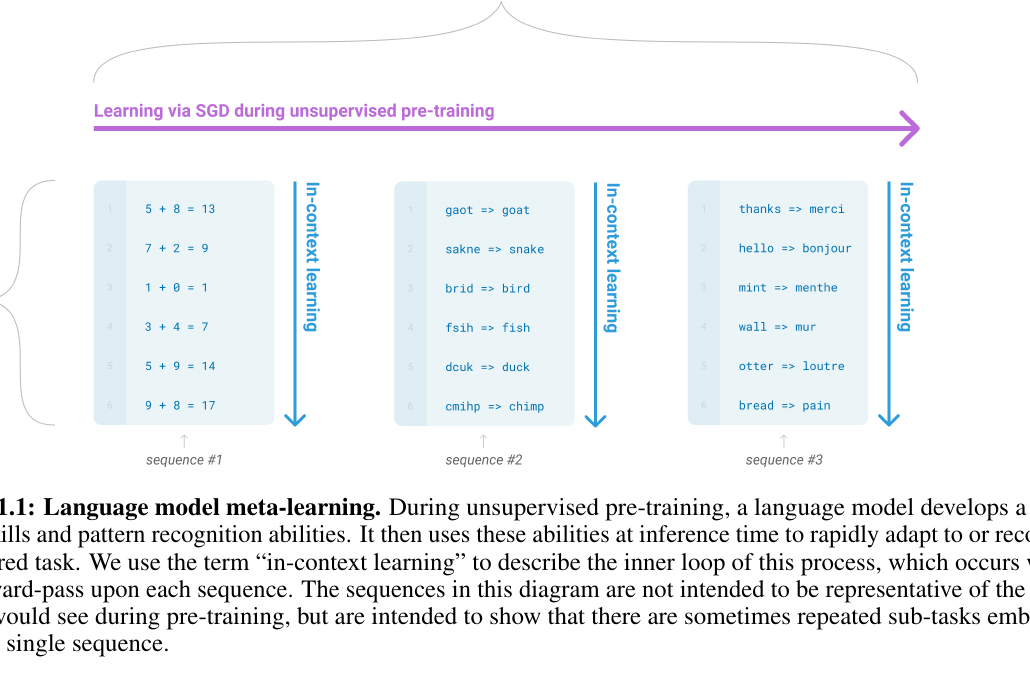
Figure 1.1 是我觉得这篇最该先看懂的图。它不是结果图,而是在给 few-shot prompting 一个解释框架。
作者把语言模型的学习分成两层。
外层是预训练。模型在海量文本上做 next-token prediction,参数里慢慢吸收语言模式、知识、任务格式和一些推理套路。这一步会更新参数。
内层是推理时的 in-context learning。prompt 里给任务说明和几个例子,模型在一次 forward pass 里识别当前任务,然后继续生成。这里没有参数更新。
比如:
English: cat
French: chat

English: dog
French: chien

English: book
French:
模型看到前两个例子后,识别出“这是英译法任务”,然后去补最后一个。这个过程看起来像临时学习,但参数没有变。变的是当前上下文条件下的输出分布。
所以我现在会把 in-context learning 理解成:
prompt 里的 examples 像一个临时小训练集,
但学习发生在 forward pass 里,不发生在 optimizer 里。
这也是 GPT-3 和传统 fine-tuning 最大的接口差异。
模型为什么能做到:主要还是 scale
这篇文章没有复杂新架构。GPT-3 基本沿用 GPT-2 的 decoder-only Transformer,做了一点 attention pattern 调整:交替使用 dense attention 和 locally banded sparse attention。
真正吓人的地方在 Table 2.1。
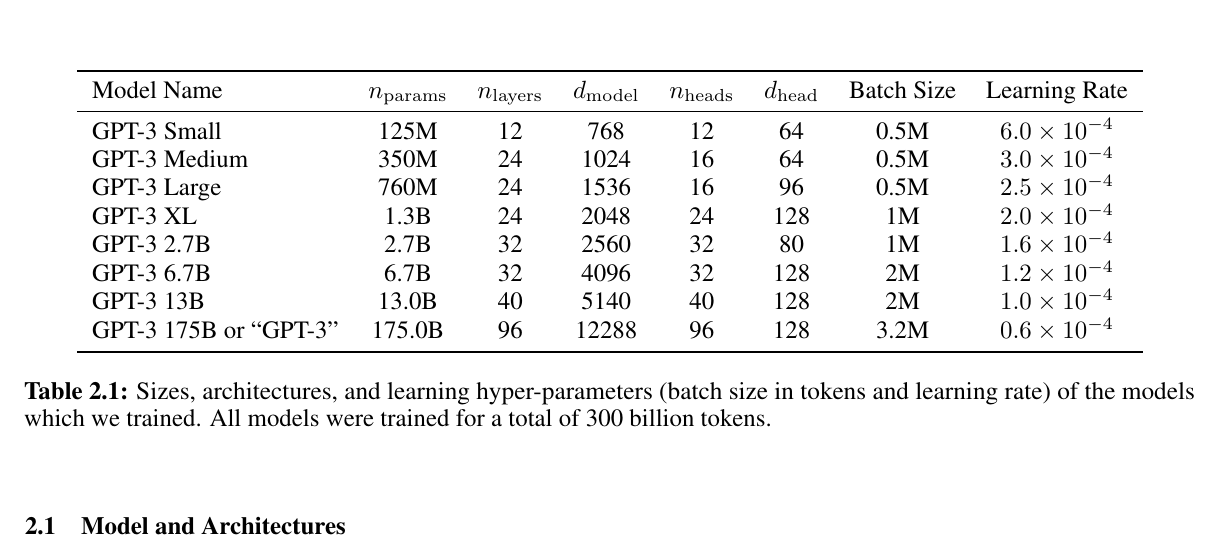
GPT-3 训练了 8 个尺寸:
125M
350M
760M
1.3B
2.7B
6.7B
13B
175B
最大模型是 175B。当时 GPT-3 前面最大的 dense / non-sparse language model,大概是 Microsoft Turing-NLG 的 17B。GPT-3 直接又放大了 10 倍。
参数量怎么上去?主要是三件事:
n_layers: 12 -> 96
d_model: 768 -> 12288
n_heads: 12 -> 96
d_head 是每个 attention head 的维度,不是 head 数。最大模型里:
n_heads = 96
d_head = 128
96 * 128 = 12288 = d_model
所以可以粗略理解为:每个 token 的表示变得很宽,层数也变深,再把这个宽度分成更多 attention heads。
这里还有个容易混的词:attention head 和 LM head 不是一回事。
attention head 是 Transformer 层内部做多头注意力的“头”。LM head 是最后把 hidden state 映射到词表 logits 的输出层,也叫 output projection、vocabulary projection、pre-softmax linear layer。
embedding: token id -> vector
LM head:   vector -> token logits
这两个都叫 head,但位置和作用完全不同。
它是不是严格只控制参数量?
不完全是。
GPT-3 的 8 个模型都训练 300B tokens,用同一套数据 mixture,context window 都是 2048。这让参数量成为最明显的变量。
但学习率和 batch size 没有死死固定。论文说,大模型通常能用更大的 batch size,但需要更小的 learning rate。比如最大模型 batch size 是 3.2M tokens,learning rate 是 0.6e-4。
所以这不是高中物理式的“只改一个变量”。更准确地说,它是一组按 scaling recipe 配出来的模型族。作者想观察的是:在相似训练策略下,模型容量和训练 compute 增加后,loss 和下游 few-shot 能力是否平滑提升。
Figure 1.2 和 1.3:大模型更会用上下文
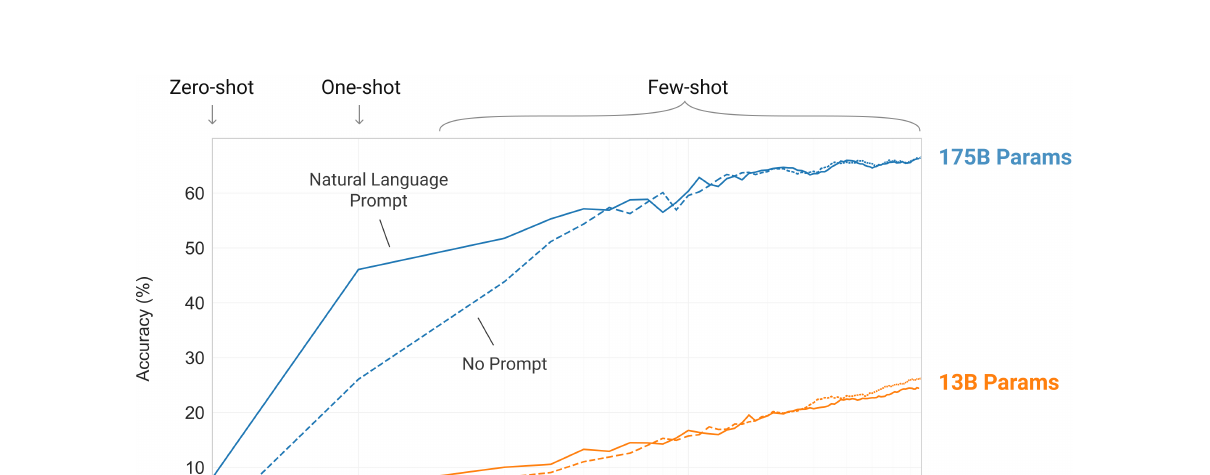
Figure 1.2 展示了一个简单任务:从单词里删掉随机插入的符号。小模型看到几个例子后提升有限,大模型的曲线更陡。
这张图想说的不是“175B 会做这个小玩具任务”。它想说,大模型更会利用上下文里的 pattern。
Figure 1.3 把很多 benchmark 聚合起来看。
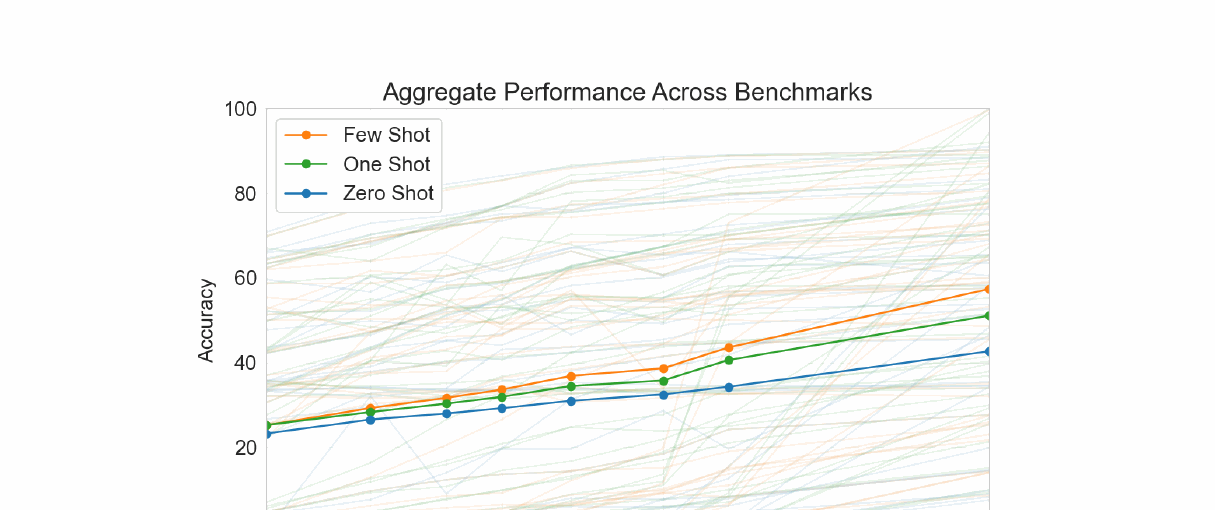
最有意思的是 gap。zero-shot、one-shot、few-shot 之间的差距会随着模型变大而扩大。
如果模型只是“知道更多”,zero-shot 也会涨。但 few-shot 比 zero-shot 涨得更快,说明大模型不只是参数里知识更多,它还更会读 prompt 里的例子,并据此调整当前任务的输出。
这就是 GPT-3 最核心的证据链:
参数越大 -> loss 更低
参数越大 -> 下游任务更强
参数越大 -> few-shot 相对 zero-shot 的优势更明显
最后一点最重要,因为它指向 in-context learning,而不只是记忆更多文本。
数据集:不是只堆 Common Crawl
GPT-3 的数据章我不想逐字读,但 recipe 要记。
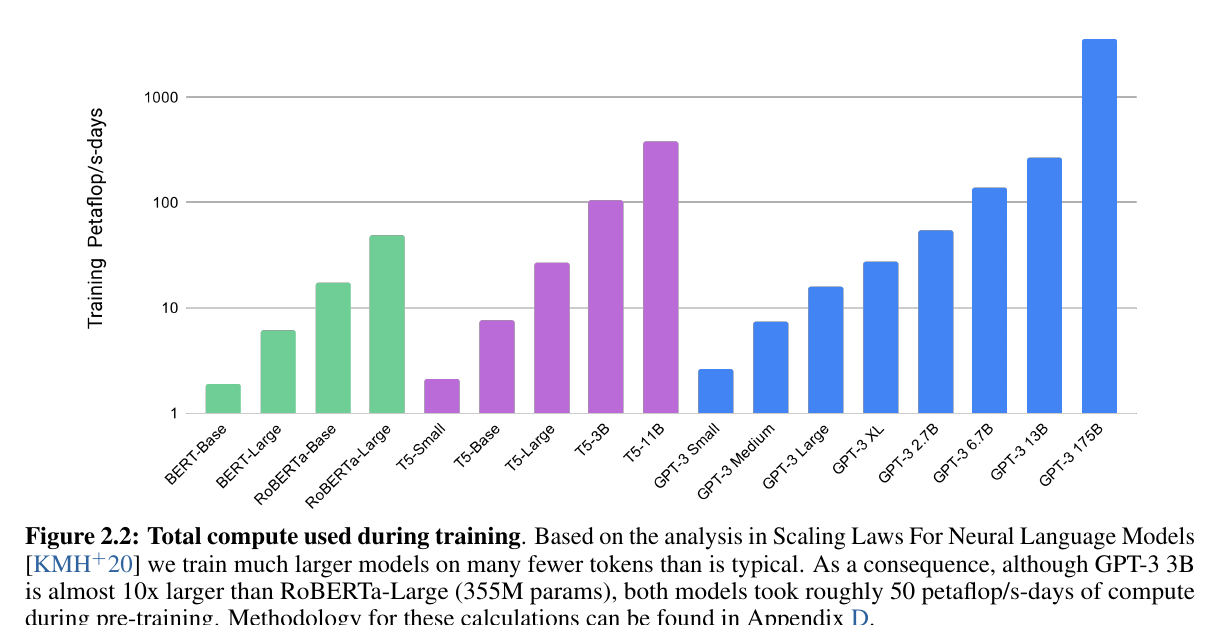
训练数据主要有五类:
Filtered Common Crawl: 410B tokens, weight 60%
WebText2:              19B tokens,  weight 22%
Books1:                12B tokens,  weight 8%
Books2:                55B tokens,  weight 8%
Wikipedia:             3B tokens,   weight 3%
这里最值得注意的是:它不是按数据集大小比例采样。
Common Crawl 很大,但噪声也大。WebText、Books、Wikipedia 量小,但质量更高。所以 GPT-3 让高质量数据被更频繁采样。Wikipedia 只有 3B tokens,但训练 300B tokens 时会走到 3.4 个 epoch;Common Crawl 有 410B tokens,却只走 0.44 个 epoch。
这个配比不是一个自动搜索出来的最优解,更像人工 recipe。原则很朴素:
大规模 web 数据保证覆盖面。
高质量 curated 数据提高文本质量。
接受一点重复,换更好的训练分布。
Common Crawl 内部倒是有更具体的过滤。作者用 WebText、Wikipedia、Books 这类高质量文本做正例,用原始 Common Crawl 做负例,训练一个 logistic regression 分类器给网页打分,然后按分数重采样。再加文档级 fuzzy dedup。
今天看,这个数据工程很粗糙。和 FineWeb、Dolma、LLaMA 3、DeepSeek-V3 那些后来的数据报告相比,GPT-3 写得不细。但它已经有现代 LLM 数据工程的影子:过滤、去重、高质量数据过采样、benchmark contamination 检查。
训练过程其实很朴素,但工程不朴素
算法上,GPT-3 的训练没什么花活:
next-token prediction
Adam optimizer
cosine LR decay
linear warmup
gradient clipping
weight decay
2048 token sequences
这不是今天那种会仔细讲 infra、数据 loader、稳定性、checkpoint、并行细节的技术报告。
但不能把它想成“拿一个 LLaMA-Factory 类似框架直接训一下”。LLaMA-Factory 更像是给已有模型做 SFT、LoRA、偏好训练。GPT-3 是从头预训练 175B dense model。
2020 年要做这件事,工程上很重:
模型要沿 depth 和 width 切到多 GPU
数据管线要喂满 V100 集群
batch size 要做到百万 tokens
训练过程要稳定跑很久
论文没细讲,不代表没有难度。只是这篇文章的主线不是训练系统,而是 scale 之后的 few-shot 现象。
结果部分:大规模 benchmark sweep
Section 3 基本是在各种数据集上跑 zero-shot、one-shot、few-shot。读的时候不用逐个 benchmark 背。
我只看三条线。
第一,validation loss 是否继续按 power law 下降。
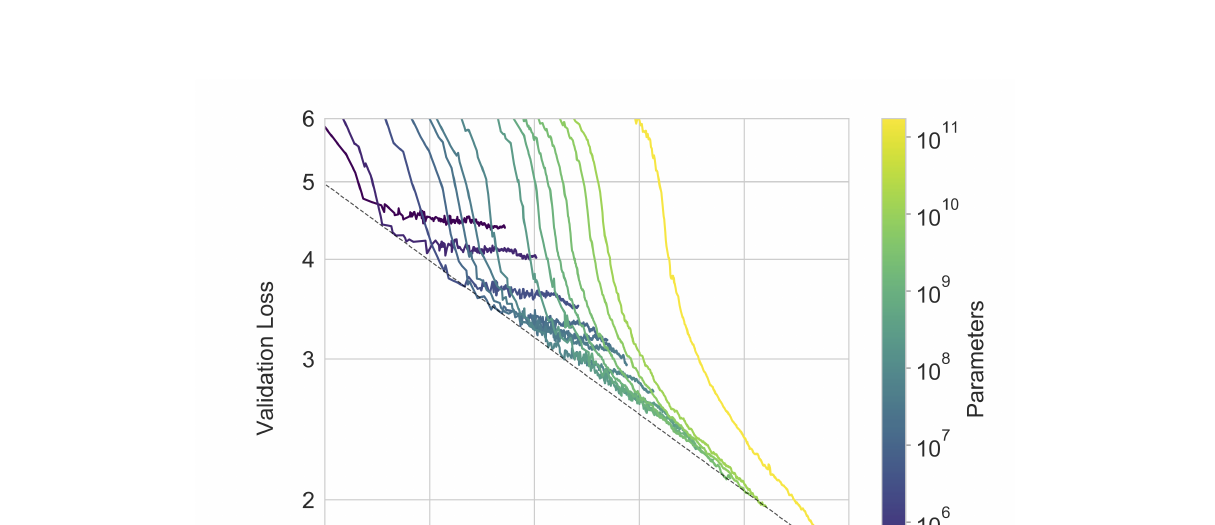
Figure 3.1 说明,把 scale 往上推两位数量级以后,loss 仍然基本沿着 scaling law 往下走,没有明显撞墙。
第二,下游任务是否也跟着变强。GPT-3 跑了 language modeling、cloze、closed-book QA、translation、Winograd、commonsense reasoning、reading comprehension、SuperGLUE、NLI、一些合成任务。大多数任务上,模型越大越强。
第三,few-shot 是不是比 zero-shot 更吃 scale。很多任务上都是这样。这是 GPT-3 论文最想让你相信的点。
当然也有短板。ANLI 这种 NLI 任务、RACE 和 QuAC 这类阅读理解,GPT-3 仍然不稳。它在生成新闻、语法纠错、使用新词造句这类 qualitative tasks 上很惊艳,但深层推理、鲁棒泛化和长文本理解还远没解决。
所以结果部分不是“GPT-3 万能”。更准确是:
scale 显著增强了通用 LM 的 few-shot 能力,
但 scale + prompt 还不能解决所有推理和阅读问题。
后来的 instruction tuning、RLHF、chain-of-thought、process supervision、DeepSeek-R1,大多是在补这些坑。
第四章:它知道自己可能数据泄露
GPT-3 训练数据来自互联网,所以测试集污染是个绕不开的问题。第四章就是在做 contamination audit。
作者原本尝试移除 benchmark dev/test set 和训练语料的 overlap,但过滤有 bug,只删掉了一部分。训练 175B 成本太高,也没法重训。于是他们做 post-hoc 分析。
做法大概是:
用 13-gram overlap 查每个 benchmark 样本是否可能出现在训练语料里。
有重叠的标 dirty。
没重叠的标 clean。
只在 clean subset 上重新评估。
比较 clean score 和 full score。
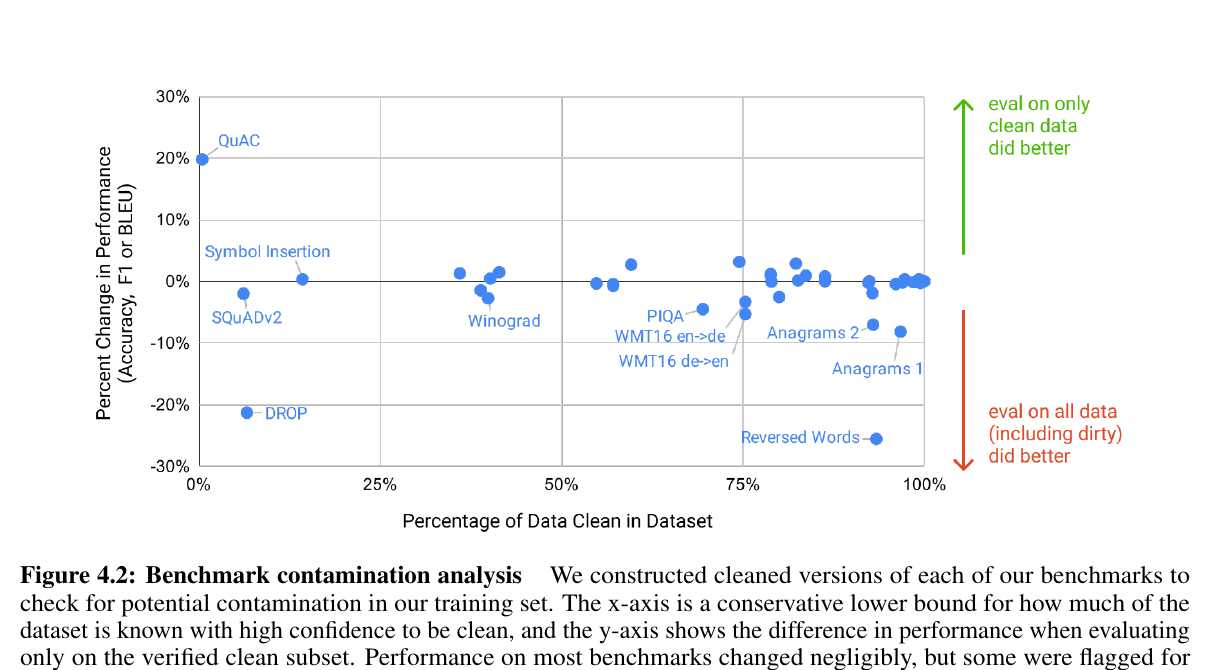
总体结论是:潜在 contamination 很常见,但大多数 benchmark 上 clean subset 和 full set 分数差不多,没有证据表明大多数结果被严重污染。
但它也承认几个例外:
PIQA 有污染风险,结果标星。
Winograd 有污染风险,结果标星。
Wikipedia language modeling tasks 和 Children's Book Test 几乎完全在训练数据里,所以不报告。
LAMBADA 有明显 contamination,但 clean subset 差异很小,所以保留并提醒。
这章今天看反而更有意义。大模型训练语料越来越大,benchmark 很容易被网页、GitHub、教程、论文、题解间接污染。GPT-3 至少很早就把这个问题摆到台面上。
Broader impacts 写得很长,但不是废话
GPT-3 后面有很多 broader impacts。第一次读会觉得怎么突然不讲技术了。现在我觉得它其实很自然。
因为 GPT-3 已经不是一个只在 benchmark 上报分的模型。它能生成新闻、回答问题、仿写文本,普通用户可以用自然语言调用它。这会立刻带来几个现实问题:
假新闻和批量文本生成
垃圾邮件和 phishing
冒充真人评论
偏见和代表性问题
训练大模型的能源消耗
这部分今天看有点早期 safety / alignment 讨论的味道。当时还没有 ChatGPT,但 GPT-3 已经让作者意识到:scale 带来的不只是能力,也带来部署和滥用问题。
我最后怎么理解 GPT-3
这篇不是模型结构论文,也不是 scaling law 的创始论文。
我会把它理解成:
用一个历史级参数规模的自回归语言模型,
证明 scale 可以让 next-token prediction 产生可用的 in-context task adaptation。
它真正改变的是任务接口。
以前是:
一个任务 -> 一个数据集 -> fine-tune 一次
GPT-3 之后,大家开始更认真地相信:
一个大模型 -> prompt 写任务 -> 推理时适配
这不表示 fine-tuning 结束了。后来的 SFT、RLHF、DPO、RLVR 都还要训练。但 GPT-3 把一个很重要的接口打开了:自然语言说明和上下文例子本身,可以成为调用模型能力的方式。
所以我最后真正记住的是这句话:
GPT-3 真正改掉的不是结构,
而是任务接口。
prompt 开始变成调用模型能力的方式。
而这件事的底层赌注很简单,也很粗暴:参数、数据和 compute 继续往上堆,模型会更会利用上下文。GPT-3 证明这个赌注在 2020 年是赢的。
下一篇该读 Scaling Laws。因为读完 GPT-3 再回头看 scaling law,会更清楚一个问题:GPT-3 为什么敢这么堆?以及后来 Chinchilla 为什么又说,不能只堆参数。